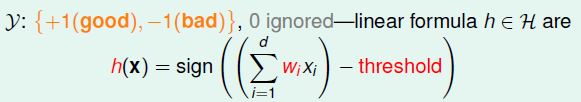2016年8月19日 星期五

[學習筆記6] 機器學習基石 - Types of Learning :: Learning with Different Protocol

Batch Learning 

這邊的Batch指的ㄧ批的"批"。在不告訴演算法的狀況底下,丟入一批資料要資料進行分類,

例如輸入一批的E-mail資料交給機器學習演算法進行分類。


Online Learning

像排隊一樣,循序的處理資料,按照順序進行標籤與分類的動作。如果先前垃圾郵件自動篩

選機制如果判斷錯誤,像是垃圾郵件結果被判定不是,以及不是垃圾郵件卻被判定是垃圾郵

件,我們可以將這些錯誤的結果一筆一筆逐步進行修正,這便是online learning的主要概念。

PLA演算法的概念也可以應用在online learning上。一筆一筆檢察,如果正確分類,則跳過該

結果;若分類錯誤,則逐步進行修正。


Active Learning

這些與資料溝通的方式可以對應到學生平常學習的概念

Batch Learning就像填鴨式教育 ('duck deeding'),一次丟一堆問題給你,等你寫完答案之後再

來看你寫得對不對

Online Learning 則是一個例子一個例子的被動式教學('passive sequential'),像是數學一樣,一題例題教完之後再換下一題。

這些學習方法都顯得被動,因此我們能不能夠讓機器自己提出問題來讓機器的答題能更快?

因此誕生了Active Learning,讓程式能夠主動問問題。


[學習筆記5] 機器學習基石 - Types of Learning :: Learning with Different Data Label

Supervised vs Unsupervised


  • Supervised Learning 監督式學習 (Core Tool 本課的重點工具~)


是一個機器學習中的方法,可以由訓練資料中學到或建立一個模式(函數 / learning model),並依此模式推測新的實例。訓練資料是由輸入物件(通常是向量)和預期輸出所組成。函數的輸出可以是一個連續的值(稱為迴歸分析),或是預測一個分類標籤(稱作分類) --Wiki - 監督式學習[1]

就像老師一開始告訴大家一元、五元、十元到五十元硬幣個別是什麼之後,讓學生練習去分類。


  • Unsupervised Learning 非監督式的學習


非監督式學習是一種機器學習的方式,並不需要人力來輸入標籤 --Wiki - 監督式學習[2]

非監督式的學習,是一開始沒有告訴演算法某些東西是什麼,讓演算法自己找出規則嘗試去分類或是分群

最後補充一段我覺得蠻有趣的話,這個適用在很多領域的知識裡 : 
分類器的表現好壞很大程度地跟被分類的資料特性有關。沒有單一分類器可以在所有的問題上都表現最好,這被稱為『天下沒有白吃的午餐理論』。

各式的經驗法則被用來比較分類器的表現及確認分類器表現的資料特性。決定適合某一問題的分類器仍舊是一項藝術,而非科學。
( 我 : 表示還有很多事情是目前科學知識力有未逮之處,才會以經驗公式來帶過XD )  


  • Semi Supervised Learning 半監督式學習


半監督式學習與監督式學習的差別在於,半監督式的不是所有的資料點都有標記。其餘未標記的資料則要依靠學習演算法來完成分類或分群任務。


參考資料

[1]監督式學習 - Wiki

[2]非監督式學習 -Wiki

2016年8月18日 星期四

[學習筆記4] 機器學習基石 - Types of Learning :: Learning with Different Output Space

前面的東西再做個小小複習 : 


找到模型g (代表下圖的黑線) 能夠正確分開資料之後,之後輸入資料後

就可以根據g的規則來對新的資料進行分類動作


二元分類 (Binary Classification)是機器學習裡最基礎的分類器。

在分辨不同類別的資料上,統計學已經針對這個問題有了伸入的研究,叫作回歸分析(Regression Analysis)

節錄交大工工系 統計學(二)的講義中對於回歸分析的解釋

回歸分析[1] 的主要目的是探究一個或數個自變數(independent variable) 和一個因變數(dependent variable) 間的關係,進而建構一個適當的數學方程式,並利用此方程式來解釋或預測因變數之值。在迴歸分析中自變數(又稱解釋變數)以X 表之,因變數(又稱反應變數)以Y表之;自變數X與因變 數Y之間的函數關係或數學方程式,稱為迴歸模式。

Ex. 某人有某些特徵,他有某癌症的比率多高 ?


或是,探討與分析結構的機器學習方式 (錄如,自然語言處理Natural Language Processing )


參考資料:

[1] 交大工工系 統計學(二)講義  授課教師 : 唐麗英教授

[學習筆記3] 機器學習基石 - Learning to Answer Yes/No :: Non-Separable Data

Non-Linear Separability Problem

資料若屬於線性可分割(Linear separate)當然是最好

但是問題來了,真實世界裡總是不是那麼理想,總有幾個頑固份子破壞了和諧

若手上有今天非線性可分割的資料點該怎麼辦?


對於這些有雜訊存在的資料點,我們可以使用近似的方法,找到"最合適"的解


Pocket Algorithm - 與Greedy Algorithm近似的演算法

林軒田老師以小朋友手上有個玩具,還想要在抓其他的玩具來作比喻 (我 : 吃碗內看碗外)

Pocket Algorithm 是手上有一個近似解之後,再繼續尋找更合適的解


Pocket Algorithm( PLA的變形) 與 PLA的核心想法類似

但是運算上 Pocket Algorithm比 PLA演算法計算速度更久的原因在於 :

1.  但是Pocket演算法需要額外儲存目前已運算完的結果

2.  PLA演算法只要check目前這組裡面有什麼資料點分類錯誤,一找到就立刻更新權重值,直到找到最佳解就停止。但是Pocket演算法面對得可能是非線性可分割,因此需要檢查所有的分類結果,直到找到最適合的那組解為止。在相同事情上,Pocket演算法花費的時間會更久。

Learning to Answer Yes/No 小結

最後,對於前面的學習內容來個總結 : 

Perceptron Hypothesis Set (Set of candidate formula)與PLA演算法 

可以解決可線性分割(Linear Separability)的分類類別

至於非線性分割(Non-Linear Separability)的問題,則要仰賴Pocket演算法求得近似解

註 : 這邊的Perceptron模型就是H中的其中一個模型


[學習筆記2] 機器學習基石 - Learning to Answer Yes/No :: Guarantee of PLA

Linear Separability


證明題 1


證明題 2


在 14頁的地方我就卡住了

這個部分我還在嘗試 : P

兩個直槓[1]似乎也是絕對值的意思

[1] http://goo.gl/1wTYkc

[學習筆記1] 機器學習基石 - Learning to Answer Yes/No :: Perceptron Learning Algorithm

前情題要 : 

A takes D and H to get g = 機器學習演算法A由訓練資料D與可能的預測模型資料庫,找出最合適的最終預測模型g

回到一開始的信用卡的發卡驗證問題, 今天我們想要找到一個預測模型 f ,能夠讓我們丟入申請辦卡人的資料X之後,得到誰適合申辦信用卡的結果Y。

但在不知道f的情況下(天下沒有白吃的午餐,一切還是要自己來: P),透過過去的歷史紀錄D,配合機器學習演算法A,從假設組合H  (H中包含多種可能的模型)裡面選一個預測模型g (但g前幾次的預測效果可能不佳,需要機器學習演算法A多次的修正參數進行調整) 

將資料x丟入最接近真實模型f的訓練模型g之後,便能夠得到結果Y


Perceptron Learning Algorithm (感知層學習演算法, PLA) [1] 

(Q: 如何證明在有限步驟內可以找到最後的解答 ?)

資料分類

在作PLA之前,首先來將資料點來進行一個分類


Sign函數[2]會根據 Sigma算出來的結果 (內含資料權重值*該項目資料數值)

減去 Threshold(門檻值) 的大小來判定

若符合條件,則判定為good,賦予 +1 值;反之,則為bad,賦予 -1 值

這邊的 h即為perceptron (感知神經元)


詳情可以看類神經網路


PLA演算法

PLA 林軒田老師戲稱叫作 知錯能改演算法

演算法過程如下面的投影片所表示

1. 首先演算法會隨機選擇一條線作為起始點

(當然,不考慮最佳化的情況下,若選的位置不好可能會需要多幾次運算次數)

然後檢查所有的資料點分類是否正確

2. 若有錯誤,則修正權重數值

3. 若有錯誤則繼續重複步驟2,直到找到可以正確分類的分割線為止

(答案可能不只有一個)


參考文獻 :

[1] 感知學習演算法(Perceptron Learning Algorithm)白話說明

[2] 符號函數 - Sign()  Wiki


別人寫得筆記,更為用心跟詳細,分想給大家

林軒田教授機器學習基石 MACHINE LEARNING FOUNDATIONS 第二講學習筆記

2016年7月31日 星期日

[電腦視覺] RANSAC演算法


Wiki百科上的記載[1] - Random sample consensus (RANSAC) is an iterative method to estimate parameters of a mathematical model from a set of observed data which contains outliers.

核心精神就是利用隨機抽取兩點資料,連成一條線後(即擬合線,fitting line),去計算在這條擬合線往兩側距離特定範圍d內,內含的資料點(即inliers)數目有多少。

透過迭代(iterative[2])的方式(即在程式中利用迴圈達成)找到最多資料點符合的擬合線,即為所要搜尋的解答。


圖一、擬合線

影片一這段搞笑影片裡面,表達出了RANSAC演算法的流程,enjoy!

影片一、搞笑的RANSAC之歌

[1] 維基百科上面有詳細的說明,包含程式演算法的概念

[2] 迭代法與遞迴之間的差異說明 
/* 載入prettify的autoloader */ /* 載入JQuery */